تنظيم قاعدة معرفة عربية للمساعد الذكي: ملفات واضحة ومصادر قابلة للتحديث
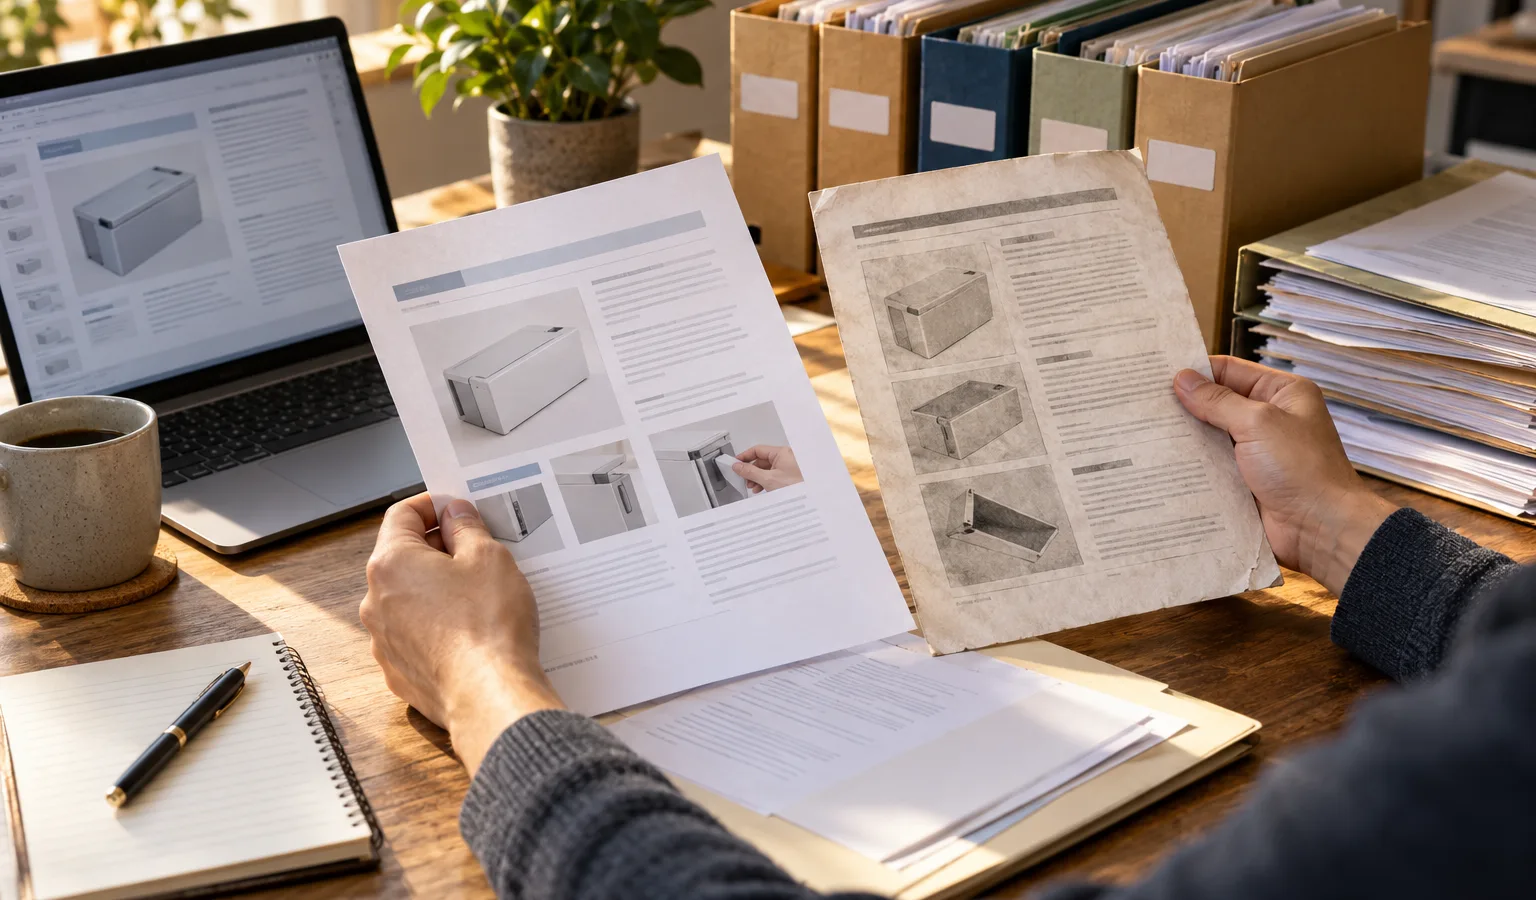
نبدأ هذه الورشة التطبيقية بفتح ملف افتراضي حقيقي المشكلات، يحمل الاسم «دليل السياسات والدعم الشارح 2022 محدث نهائي»، وهو مستند نصي ممتد على أربعين صفحة تجمع بين أحكام الضمان، وشروط التوصيل في المملكة العربية السعودية ومصر، وقواعد الاسترجاع. عند معاينة الصفحات الأولى من هذا الملف، نجد نصاً ينص بوضوح على أن «التوصيل مجاني لجميع الطلبات التي تتجاوز قيمتها مائتي ريال أو ما يعادلها بالجنيه المصري». ولكن عند الانتقال إلى الصفحة الخامسة عشرة ضمن قسم متفرع آخر، نلاحظ فقرة حاشية أضيفت لاحقاً تقول: «تم إيقاف الشحن المجاني للمناطق البعيدة بدءاً من منتصف العام الماضي بقرار إداري». هذا التناقض الصريح داخل المستند نفسه هو النموذج الأبرز لما يربك المساعد الذكي عند بناء قاعدة معرفة عربية للمساعد الذكي، حيث يستدعي المحرك المقاطع النصية بناء على التشابه الدلالي أو الكلمات المفتاحية دون أن يملك القدرة الذاتية على ترجيح أي الفقرتين هي النافذة قانونياً أو عملياً ما لم تكن بنية المستند واضحة ومحددة التاريخ والصلاحية.
افتح الملف القديم وحدد ما الذي يربك القارئ
لا تقتصر الربكة على التناقض المباشر بين التواريخ، بل تمتد إلى الأسلوب التحريري الغامض الذي يعتمد على الضمائر والإشارات الإحالية المبهمة. فالمستند القديم، على سبيل المثال، يتضمن فقرات تبدأ بعبارات مثل «وتطبق الاستثناءات المذكورة في البند السابق على العروض الموسمية فقط»، دون تحديد اسم العرض أو رقم البند المباشر. عند تقسيم المستند لأغراض البحث الدلالي، تتجزأ الفقرة بعيداً عن مرجعها الأصلي، مما قد يدفع المساعد الذكي لنسب الاستثناء خطأً إلى أي عرض تجاري آخر يظهر في نص الاستعلام. بالإضافة إلى ذلك، يؤدي إقحام التعديلات في شكل ملاحظات جانبية أو نصوص داخل صور توضيحية إلى تجاهل الخوارزميات للقيود الجوهرية، فتصوغ إجابات تبدو موثوقة ونحوية، لكنها تدفع العميل إلى استنتاجات خاطئة تماماً حول حقوقه أو تكاليف الخدمة.
للفصل بين تجهيز المحتوى وطريقة استرجاعه، يمكن الرجوع إلى RAG عملياً لفهم بنية الاسترجاع، ثم العودة هنا لمراجعة المستندات نفسها. إن القرارات التحريرية التي تتخذها أثناء تفكيك الملف القديم تتطلب الوقوف على كل فقرة وتقييم ما إذا كانت توفر معنى كاملاً بنفسها أم لا. في ملفنا الافتراضي، نجد أن قسم ضمان الأجهزة الإلكترونية يتضمن نصاً يقول «تغطي الكفالة الأعطال المصنعية لمدة عامين»، بينما يختبئ شرط استثناء الأجهزة المعاد تجديدها في نهاية فصل الملحقات بعيداً عن القواعد العامة. الحل التحريري المباشر هنا ليس مجرد تنظيف التنسيق، بل هو إعادة تجميع السياسة ومحدداتها في وحدة نصية واحدة متماسكة تجعل القاعدة العامة والاستثناء مقترنين دائماً في المقطع المسترجع.
لنتأمل حالة فشل تعليمية من واقع مراجعة المستند القديم: عند توجيه سؤال تجريبي للنظام مثل «هل يشمل الضمان استبدال الشاشة في حال السقوط الحر لشركة تعمل في الرياض والقاهرة؟»، استرجع المساعد الذكي فقرة الضمان العام التي تنص على أن «جميع الأعطال التي تمنع التشغيل مغطاة بالكامل خلال سنة من الشراء»، لكنه أغفل فقرة صريحة في ملحق منفصل تنفي تغطية الأضرار الناتجة عن سوء الاستخدام أو السقوط. لم يكن سبب الفشل ضعف نموذج الذكاء الاصطناعي، بل انشطار النص إلى مقطعين متباعدين تحريرياً داخل الملف الأصلي، حيث افتقرت الفقرة الأولى إلى أي إشارة صريحة تحيل إلى الملحق المتضمن للاستثناءات. تطلبت معالجة هذه الحالة إلغاء الملحق المكتفي بذاته، وإدماج عبارات النفي والاستثناء مباشرة تحت بند الضمان العام، مع تضمين الكلمات المفتاحية المتعلقة بالأضرار العرضية ضمن النص الأصلي نفسه.
تتطلب مراجعة المستند القديم أيضاً معالجة التباين في المصطلحات المستخدمة عبر أجزائه المختلفة؛ فالمستند الافتراضي يطلق على العملية نفسها تارة «إعادة المنتجات» وتارة أخرى «الاسترجاع النهائي» وتارة ثالثة «إلغاء الطلب»، مما يشتت محرك البحث أثناء مطابقة المفردات العربية الشائعة لدى المستخدمين في مختلف الأسواق العربية. ينبغي على الفريق التحريري في هذه المرحلة إعداد حصر دقيق يحدد المصطلحات المعتمدة ويوحدها عبر جميع الفقرات، مع إزالة كافة الملاحظات الشفهية والمسودات المتراكمة التي أضيفت بواسطة محررين متعددين عبر السنوات. إن تنقية المستند من النصوص المتروكة وتوحيد بنية الفقرات يضمنان عدم تسرب معلومات ملغاة إلى الإجابات، ويضعان الأساس الصلب لبناء قاعدة معرفة عربية للمساعد الذكي تستند إلى مادة مصدق عليها وقابلة للتتبع.
تتمثل الخطوة الأخيرة في هذا الفحص التحريري الأولي في استخراج كافة المعلومات التي انتهت صلاحيتها الزمانية أو المكانية ونقلها خارج الملف الرئيسي. ففي ملفنا الافتراضي، يظهر بند ينص على «خصم خاص بمناسبة افتتاح فرع جدة خلال شهر مارس»، وقد ظل هذا البند مدفوناً داخل ملف السياسات لسنوات بعد انتهاء الاقتراح التجاري. يسبب وجود هذه الفقرات المهجورة مخاطر عالية عندما يستفسر المستخدم عن الخصومات المتاحة حالياً، حيث يميل النظام إلى التقاط النسب المئوية والأرقام المذكورة واستخدامها كأدلة حية. لعزل هذه الفقرات المنتهية وتدوين تواريخ السريان بوضوح على كل نص متبقٍ، نضمن أن عملية الاسترجاع تستند حصرياً إلى سياسات جارية ومحددة، مما يقلل من نسب الأخطاء الناتجة عن المحتوى التقادمي ويضمن تحكماً كاملاً في مخرجات النظام.
تصف وثائق OpenAI البحث في الملفات كأداة لاسترجاع معلومات من ملفات مرفوعة بالاعتماد على البحث الدلالي والبحث بالكلمات. OpenAI file search documentation
حوّل المستند إلى وحدات لها غرض ومالك واضح
بعد الانتهاء من تنقية المستندات القديمة وتوحيد المصطلحات وإزالة المعلومات المنتهية الصلاحية، ننتقل إلى مرحلة جوهرية في بناء قاعدة المعرفة العربية للمساعد الذكي: تحويل هذه المستندات المنظمة إلى وحدات معلوماتية مستقلة، لكل منها غرض واضح ومالك محدد. هذه الخطوة لا تقتصر على مجرد تقسيم الملفات، بل هي عملية إعادة هيكلة تضمن أن كل معلومة يمكن استرجاعها بدقة، وتحديثها بكفاءة، وربطها بالمسؤول عنها. لنفترض أننا عملنا على ملف «سياسات المنتجات والخدمات» الذي كان يجمع كل شيء من سياسة الإرجاع إلى تفاصيل الشحن والضمانات، بعد تنقيته، صار لدينا الآن مستند واحد طويل وموحد، لكنه ما زال يحتاج إلى التفكيك.
تبدأ هذه العملية بتحديد الأقسام المنطقية داخل المستند الموحد. في مثالنا الافتراضي لملف «سياسات المنتجات والخدمات»، يمكننا أن نميز أقسامًا مثل: «سياسة إرجاع المنتجات»، «شروط ضمان المنتجات الإلكترونية»، «تفاصيل الشحن والتوصيل»، «خيارات الدفع المتاحة»، و«خدمة ما بعد البيع». كل من هذه الأقسام يمثل وحدة معلوماتية متكاملة يمكن فصلها. القرار العملي هنا هو ما إذا كنا سنفصل هذه الأقسام إلى ملفات مستقلة تمامًا أو نكتفي بتقسيمها داخل ملف واحد كبير باستخدام عناوين واضحة. في سياق المساعد الذكي الذي يعتمد على البحث في الملفات، فإن فصلها إلى ملفات مستقلة غالبًا ما يكون الخيار الأفضل لأنه يتيح إدارة أكثر دقة للمحتوى والبيانات الوصفية (metadata) لكل وحدة.
عند فصل هذه الأقسام، يصبح لكل ملف جديد غرض واحد وواضح. على سبيل المثال، الملف المعنون «سياسة إرجاع المنتجات.pdf» سيحتوي فقط على كل ما يتعلق بإرجاع المنتجات، بما في ذلك الشروط العامة والاستثناءات. وبالمثل، «شروط ضمان المنتجات الإلكترونية.pdf» سيحتوي على تفاصيل الضمان المحددة لهذا النوع من المنتجات. هذه التجزئة تجعل عملية الاسترجاع أكثر كفاءة، حيث يمكن للمساعد التركيز على ملفات محددة بناءً على استفسار المستخدم، بدلاً من البحث في مستند ضخم قد يحتوي على معلومات غير ذات صلة. وتساعد هذه الطريقة في تقييد البحث ببيانات وصفية للملفات، وهو ما تدعمه وثائق البحث في الملفات، مما يعني أن اختيار الحقول والقيم الصحيحة لهذه البيانات الوصفية يصبح جزءًا أساسيًا من تصميم قاعدة المعرفة.
تتمثل الخطوة التالية في تحديد المالك لكل وحدة معلوماتية جديدة، وهو القسم أو الشخص المسؤول عن صحة المعلومات الواردة في الملف وتحديثها بانتظام. فعلى سبيل المثال، يمكن أن يكون «قسم خدمة العملاء» مالكاً لملف «سياسة إرجاع المنتجات.pdf»، بينما يمتلك «قسم المنتجات» ملف «شروط ضمان المنتجات الإلكترونية.pdf»، ويمتلك «قسم العمليات اللوجستية» ملف «تفاصيل الشحن والتوصيل.pdf». يضمن هذا التعيين الواضح للمسؤوليات وجود جهة مرجعية واحدة لكل معلومة، مما يمنع التضارب وييسر دورة التحديث. عند إضافة البيانات الوصفية لكل ملف، يجب أن تتضمن حقولاً لـ «المالك» و«تاريخ آخر مراجعة» و«تاريخ السريان»، بالإضافة إلى أي حقول أخرى ذات صلة مثل «فئة المنتج» أو «المنطقة الجغرافية» التي تنطبق عليها السياسة. هذه البيانات الوصفية تُعد مفاتيح لمساعدة المساعد الذكي على تضييق نطاق البحث واسترجاع المعلومة الأكثر دقة وملاءمة.
لنأخذ مثالاً عملياً: في المستند الأصلي، كانت هناك فقرة تقول: «يمكن إرجاع المنتجات خلال 14 يومًا من تاريخ الشراء، باستثناء المنتجات الإلكترونية التي لا تُرد إلا في حالة عيب مصنعي خلال 7 أيام. لعملاء الرياض، خدمة الاسترجاع المجاني متاحة لجميع المنتجات». هذه الفقرة تحتوي على ثلاث معلومات مختلفة: سياسة عامة، استثناء خاص، وخدمة إقليمية. بعد التفكيك، يمكننا إنشاء الملفات التالية مع بياناتها الوصفية:
الملف الأول: `سياسة_الإرجاع_العامة.pdf` المحتوى: «يمكن إرجاع المنتجات خلال 14 يومًا من تاريخ الشراء، مع مراعاة الشروط المحددة للمنتجات الخاصة». البيانات الوصفية: `مالك: قسم خدمة العملاء`, `نوع_المستند: سياسة`, `نطاق_التطبيق: عام`, `تاريخ_السريان: 2024-01-01`, `آخر_مراجعة: 2024-05-15`.
الملف الثاني: `استثناءات_إرجاع_المنتجات_الإلكترونية.pdf` المحتوى: «المنتجات الإلكترونية لا تُرد إلا في حالة عيب مصنعي خلال 7 أيام من تاريخ الاستلام». البيانات الوصفية: `مالك: قسم المنتجات`, `نوع_المستند: استثناء_سياسة`, `فئة_المنتج: إلكترونيات`, `تاريخ_السريان: 2024-01-01`, `آخر_مراجعة: 2024-05-15`.
الملف الثالث: `خدمة_الاسترجاع_المجاني_الرياض.pdf` المحتوى: «لعملاء الرياض، خدمة الاسترجاع المجاني متاحة لجميع المنتجات المؤهلة». البيانات الوصفية: `مالك: قسم العمليات اللوجستية`, `نوع_المستند: خدمة_إقليمية`, `المنطقة: الرياض`, `تاريخ_السريان: 2024-01-01`, `آخر_مراجعة: 2024-05-15`.
في حالة الفشل، إذا لم يتم فصل هذه المعلومات بوضوح أو لم يتم تعيين البيانات الوصفية بشكل صحيح، يمكن أن يواجه المساعد الذكي تحديات كبيرة. على سبيل المثال، إذا ظل الاستثناء الخاص بالمنتجات الإلكترونية مدفوناً في ملف السياسة العامة دون بيانات وصفية مميزة، فقد يجيب المساعد خطأً بأن جميع المنتجات يمكن إرجاعها خلال 14 يوماً، متجاهلاً شرط الـ 7 أيام للمنتجات الإلكترونية. هذا الخطأ ينشأ لأن محرك البحث الدلالي قد يجد النص في الملف العام ويعتبره الأكثر صلة، خاصة إذا كان الاستفسار عاماً. للتعافي من مثل هذا الموقف، يجب إعادة مراجعة جميع الملفات التي تم تفكيكها، والتأكد من أن كل قطعة معلومات فريدة ومحددة، وأن البيانات الوصفية تعكس بدقة نطاقها وسريانها. يتضمن ذلك تحديث حقول مثل `فئة_المنتج` و`المنطقة` لضمان أن المساعد يمكنه التمييز بين السياسات العامة والاستثناءات الإقليمية أو الخاصة بفئات معينة.
تحديد المالك يسهل أيضاً عملية التعافي والتحديث. إذا اكتشفنا أن المساعد يقدم معلومات خاطئة حول سياسة الإرجاع، فإن المالك المحدد لهذا الملف (قسم خدمة العملاء في مثالنا) هو الجهة التي يجب التواصل معها فوراً لتصحيح المحتوى أو تحديث البيانات الوصفية. هذا الهيكل المنظم يضمن أن قاعدة المعرفة العربية للمساعد الذكي ليست مجرد مجموعة من الملفات، بل هي نظام حيوي يتم تحديثه وصيانته بانتظام لتقديم معلومات دقيقة وموثوقة للمستخدمين. عند تحرير الفقرات المصدرية، يساعد دليل تحسين الأسلوب مع حماية المعنى على تجنب حذف النفي أو توسيع الوعد أثناء إعادة الصياغة.
احفظ الشروط والاستثناءات والأسماء والنسخ في سياقها
بعد تقسيم المستندات الكبيرة إلى وحدات معلومات ذات غرض ومالك واضحين، تأتي الخطوة الحاسمة في ضمان دقة المساعد الذكي: وهي حفظ الشروط والاستثناءات والأسماء المحددة ونسخ المعلومات المختلفة في سياقها الصحيح. إن إهمال هذه التفاصيل يمكن أن يؤدي إلى إجابات عامة خاطئة أو مضللة، لأن المساعد قد يختار المعلومة الأقل تحديدًا إذا لم يتم توجيهه بوضوح. يتطلب هذا الأمر تفكيراً معمقاً في كيفية تفاعل كل جزء من المعلومات مع الأجزاء الأخرى، وكيف يمكن للبيانات الوصفية (metadata) أن تكون جسراً يربط السياقات المختلفة ببعضها البعض.
لنتخيل أننا نعمل على قاعدة معرفة لـ "متجر الزهور الإلكتروني"، وهو متجر يبيع الزهور الطازجة والهدايا الأخرى في مصر والسعودية. لديهم سياسات توصيل وإرجاع وعروض ترويجية تختلف حسب نوع المنتج والمنطقة الجغرافية وتاريخ الصلاحية. إذا كانت جميع هذه المعلومات مدمجة في ملف واحد كبير، فسيواجه المساعد صعوبة بالغة في التمييز بينها. على سبيل المثال، قد يكون هناك شرط عام لإرجاع الهدايا خلال 7 أيام، ولكن استثناءً خاصاً للزهور الطازجة لا يسمح بإرجاعها بعد 24 ساعة من الاستلام. إذا لم يتم فصل هذا الاستثناء وتحديده بوضوح، فقد يقدم المساعد الإجابة العامة، مما يتسبب في إرباك العميل.
لتجنب هذا، يجب تصميم بنية الملفات والبيانات الوصفية بعناية. بدلاً من ملف واحد لسياسة الإرجاع، يمكن إنشاء ملفين: الأول بعنوان "سياسة_الإرجاع_العامة_للهدايا.pdf"، والآخر بعنوان "سياسة_إرجاع_الزهور_الطازجة.pdf". لكل ملف، يتم تعيين بيانات وصفية دقيقة. لملف الزهور، يمكن أن تكون البيانات الوصفية كالتالي: `نوع_المحتوى: سياسة_إرجاع`، `فئة_المنتج: زهور_طازجة`، `مدة_الإرجاع: 24_ساعة`. بينما لملف الهدايا العامة: `نوع_المحتوى: سياسة_إرجاع`، `فئة_المنتج: هدايا_عامة`، `مدة_الإرجاع: 7_أيام`. بهذه الطريقة، عندما يسأل العميل عن إرجاع الزهور، يمكن للمساعد، باستخدام البحث الدلالي والبحث بالكلمات مع تصفية البيانات الوصفية، تحديد الملف الأكثر صلة بدقة. تصف وثائق OpenAI البحث في الملفات كأداة لاسترجاع معلومات من ملفات مرفوعة بالاعتماد على البحث الدلالي والبحث بالكلمات.
الأسماء المحددة، مثل أسماء المدن أو المنتجات، تتطلب أيضاً معالجة خاصة. على سبيل المثال، قد يكون للمتجر سياسة توصيل مجاني للطلبات فوق 200 ريال سعودي في الرياض، ولكن في جدة، قد يكون الحد الأدنى 300 ريال. إذا لم يتم تحديد السياق الجغرافي بوضوح، فقد يقدم المساعد معلومات خاطئة. الحل هو إنشاء ملفات منفصلة لكل منطقة أو مدينة، مثل "سياسة_التوصيل_السعودية_الرياض.pdf" و"سياسة_التوصيل_السعودية_جدة.pdf". يمكن أن تتضمن البيانات الوصفية لكل ملف حقل `المنطقة` بقيمة "الرياض" أو "جدة"، وحقل `الحد_الأدنى_للتوصيل_المجاني` بقيمته المحددة. تتيح وثائق البحث في الملفات تقييد البحث ببيانات وصفية للملفات. اختيار الحقول وقيمها الصحيحة يبقى جزءاً من تصميم قاعدة المعرفة.
أما بالنسبة لإدارة نسخ المعلومات، خاصة العروض الترويجية أو السياسات التي تتغير بمرور الوقت، فالقاعدة الأساسية هي عدم الكتابة فوق الملفات القديمة. بدلاً من ذلك، يجب استخدام نظام تسمية يعكس تاريخ السريان أو حالة الصلاحية. على سبيل المثال، "عرض_عيد_الأم_2024_ساري.pdf" و"عرض_عيد_الأم_2023_منتهي.pdf". يمكن أيضاً استخدام البيانات الوصفية لتحديد `تاريخ_السريان` و`تاريخ_الانتهاء` و`الحالة` (مثل: ساري، منتهي، مؤرشف). عندما ينتهي عرض 2024، يتم تحديث بياناته الوصفية إلى `الحالة: منتهي`، أو يتم نقله إلى مجلد أرشيف، أو حتى حذفه من قاعدة المعرفة النشطة إذا لم يعد هناك حاجة إليه. هذا يضمن أن المساعد لا يسترجع معلومات قديمة أو غير ذات صلة.
في حالة الفشل، إذا سأل عميل في جدة عن التوصيل المجاني واجابه المساعد بالحد الأدنى للرياض (200 ريال بدلاً من 300 ريال)، فإن المشكلة تكمن في عدم وضوح السياق الجغرافي. قد يكون السبب أن ملف "سياسة_التوصيل_السعودية_الرياض.pdf" كان هو الوحيد الذي يحتوي على كلمة "توصيل مجاني" بشكل بارز، أو أن البيانات الوصفية للمنطقة لم تُستخدم لتصفية النتائج. للتعافي، يجب مراجعة الملفات المتعلقة بسياسات التوصيل، والتأكد من أن لكل منطقة ملفها الخاص بحدودها وشروطها، وأن حقل `المنطقة` في البيانات الوصفية يتم تعبئته بدقة لكل ملف. كما يجب التأكد من أن نظام الاسترجاع يستخدم هذه البيانات الوصفية لتحديد السياق الجغرافي في استعلامات البحث.
مثال آخر للفشل يمكن أن يحدث مع العروض الترويجية. إذا سأل عميل عن "عروض عيد الأم" بعد انتهاء عرض 2024، وأجابه المساعد بمعلومات عن عرض 2023 لأنه لم يتم تحديث حالة الملف أو إزالته. هنا، يجب التأكد من أن جميع الملفات التي تحتوي على عروض ترويجية لها تاريخ انتهاء صلاحية محدد في بياناتها الوصفية، وأن نظام المساعد الذكي مصمم لتجاهل أو استبعاد الملفات التي تجاوزت تاريخ انتهائها تلقائياً. يمكن أيضاً إضافة حقل `صلاحية_المعلومة` في البيانات الوصفية وتعيينه إلى `ساري` أو `منتهي`، وتدريب المساعد على تفضيل المعلومات ذات الصلاحية `ساري`. هذا النهج لا يمنع فقط الأخطاء، بل يبني أيضاً الثقة في دقة المعلومات التي يقدمها المساعد الذكي.
تتيح وثائق البحث في الملفات تقييد البحث ببيانات وصفية للملفات. اختيار الحقول وقيمها الصحيحة يبقى جزءاً من تصميم قاعدة المعرفة. OpenAI file search documentation
اختبر الأسئلة التي تصل إلى المصدر الخطأ
بعد تنظيم ملفات قاعدة المعرفة العربية وتحديد سياقاتها ومالكيها، تأتي مرحلة الاختبار الحاسم. الهدف ليس فقط التحقق من أن المساعد الذكي يقدم إجابة صحيحة، بل والأهم هو التأكد من أنه يسترجع المعلومة من المصدر الصحيح المحدد لها. قد تكون الإجابة صحيحة بالصدفة، أو مستقاة من سياق مشابه لكنه خاطئ، مما قد يؤدي إلى تناقضات مستقبلية أو عدم القدرة على تتبع مصدر المعلومة بدقة. تبدأ عملية الاختبار بتصميم أسئلة محددة تهدف إلى الكشف عن نقاط الضعف في تنظيم المحتوى أو في استخدام البيانات الوصفية.
لنفترض أن شركة "توصيل النور"، وهي شركة شحن افتراضية تعمل في عدة مدن عربية، قامت بتنظيم قاعدة معرفتها. لديها ملفات متعددة لسياسات الشحن، منها: "سياسات_الشحن_السعودية_الرياض_2024_ساري.pdf" الذي يحدد الشحن المجاني للطلبات فوق 300 ريال سعودي في الرياض، و"سياسات_الشحن_السعودية_جدة_2024_ساري.pdf" الذي يحدد الشحن المجاني فوق 400 ريال سعودي في جدة، بالإضافة إلى "عروض_رمضان_2024_منتهي.pdf" الذي كان يقدم شحناً مجانياً فوق 200 ريال سعودي في جميع المدن السعودية خلال شهر رمضان وانتهت صلاحيته. هدف الاختبار هو التأكد من أن المساعد يسترجع السياسة السارية الخاصة بالمدينة المذكورة في الاستعلام.
نبدأ باختبار مباشر: يطرح مستخدم سؤالاً على المساعد الذكي: "هل الشحن مجاني في الرياض؟". الإجابة المتوقعة هي أن الشحن مجاني للطلبات التي تتجاوز 300 ريال سعودي، وأن هذه المعلومة مستقاة تحديداً من ملف "سياسات_الشحن_السعودية_الرياض_2024_ساري.pdf". إذا أجاب المساعد بشكل صحيح، فإن الخطوة التالية هي التحقق من المصدر الفعلي الذي استند إليه في إجابته. العديد من أنظمة المساعد الذكي توفر واجهات لعرض المصادر المسترجعة (citations) التي استخدمها النموذج لتوليد الإجابة. يجب مراجعة هذه المصادر بدقة.
لنفترض أن المساعد أجاب: "نعم، الشحن مجاني في الرياض للطلبات التي تتجاوز 400 ريال سعودي". هنا، الإجابة خاطئة والخطأ واضح. عند التحقق من المصادر، قد نجد أن المساعد استرجع فقرة من ملف "سياسات_الشحن_السعودية_جدة_2024_ساري.pdf". هذا فشل في الاسترجاع الصحيح، على الرغم من أن الملف المسترجع كان سارياً. يكمن السبب المحتمل في أن كلا الملفين يحتويان على عبارات متشابهة مثل "الشحن مجاني" و"ريال سعودي"، ولم تكن كلمة "الرياض" في الاستعلام قوية بما يكفي لتفضيل الملف الخاص بالرياض بشكل قاطع، أو أن النظام لم يستخدم البيانات الوصفية للملفات بشكل فعال لتمييز المدن.
للتعافي من هذا الفشل، يمكن اتخاذ عدة إجراءات. أولاً، يجب مراجعة محتوى الملفات نفسها. التأكد من أن كل ملف يذكر بوضوح المدينة التي تنطبق عليها السياسة في بداية الفقرات الرئيسية، مثل: "في الرياض، الشحن مجاني للطلبات…". هذا يعزز الارتباط الدلالي بين المدينة والسياسة. ثانياً، وهو الأهم، يجب التأكد من استخدام البيانات الوصفية للملفات. إذا كان كل ملف يحتوي على حقل بيانات وصفية باسم `المدينة` بقيمة مثل `الرياض` أو `جدة`، فيمكن تهيئة نظام الاسترجاع لترشيح النتائج بناءً على هذه البيانات الوصفية عندما يذكر المستخدم مدينة في سؤاله. هذا يضمن أن البحث يقتصر على الملفات ذات الصلة الجغرافية فقط، مما يقلل من فرصة استرجاع مصدر خاطئ.
مثال آخر للفشل يمكن أن يحدث إذا أجاب المساعد على سؤال "هل الشحن مجاني في الرياض؟" بالاستناد إلى معلومات من ملف "عروض_رمضان_2024_منتهي.pdf"، قائلاً: "نعم، الشحن مجاني للطلبات التي تتجاوز 200 ريال سعودي". في هذه الحالة، الإجابة ليست صحيحة للسياسة الحالية، والمصدر المسترجع هو عرض انتهت صلاحيته. هذا يكشف عن مشكلة في إدارة صلاحية المعلومات. على الرغم من أن اسم الملف يشير إلى أنه "منتهي"، إلا أن نظام الاسترجاع قد لا يكون قد أخذ هذا في الاعتبار.
لحل هذه المشكلة، يجب إضافة حقل `صلاحية_المعلومة` في البيانات الوصفية لكل ملف، وتعيين قيم مثل `ساري` أو `منتهي`، أو استخدام حقل `تاريخ_الانتهاء` لتحديد تاريخ انتهاء صلاحية دقيق. يجب بعد ذلك تهيئة نظام الاسترجاع لترشيح الملفات التي تحمل حالة `منتهي` أو التي تجاوز تاريخها الحالي `تاريخ_الانتهاء`. هذا يضمن أن المساعد لا يعتمد إلا على المعلومات الحديثة والسارية. كما يمكن إضافة إرشادات للمساعد في سياق النظام (system prompt) لتفضيل المصادر ذات الحالة `ساري` أو الأحدث تاريخاً.
لا يقتصر الاختبار على الأسئلة المباشرة، بل يجب أن يشمل أيضاً الأسئلة التي قد تثير التباساً. مثلاً، إذا سأل المستخدم عن "الشحن المجاني للمنتجات الكبيرة"، فقد يكون هناك ملف لسياسة عامة وآخر لدليل منتج معين يشير إلى شحن مجاني لهذا المنتج. يجب التأكد من أن المساعد يميز بين السياسة العامة والاستثناءات الخاصة بالمنتجات. يمكن تحقيق ذلك من خلال استخدام بيانات وصفية مثل `نوع_المستند` (مثال: `سياسة_عامة`، `دليل_منتج`)، وتدريب المساعد على تفضيل نوع مستند معين حسب سياق السؤال.
إن الهدف النهائي من هذه الاختبارات هو بناء الثقة في قاعدة المعرفة. عندما يعلم المطورون أن المساعد لا يسترجع فقط إجابات دقيقة، بل يستمدها من المصادر المعتمدة والسارية والمحددة بشكل صحيح، يصبح من الأسهل صيانة القاعدة وتحديثها. هذه العملية المستمرة من الاختبار والتحسين هي جوهر بناء مساعد ذكي موثوق به.
صمّم دورة تحديث تعرف متى يتوقف الاعتماد على معلومة
لا تقتصر فعالية قاعدة المعرفة العربية للمساعد الذكي على وضوح وتنظيم محتواها الأولي فحسب، بل تمتد لتشمل قدرتها على البقاء حديثة باستمرار. فالمعلومات، خاصة في البيئات المتغيرة، لها عمر افتراضي. قد تتغير سياسة، أو يتوقف منتج، أو ينتهي عرض ترويجي. وبدون دورة تحديث قوية، ستقدم قاعدة المعرفة إجابات مضللة، مما يقوض ثقة المستخدمين. التحدي الأساسي يكمن في إنشاء نظام لا يحدّث المعلومات فحسب، بل يقوم أيضاً بأرشفة أو إزالة البيانات القديمة بذكاء، لضمان اعتماد المساعد باستمرار على المصادر الأكثر دقة وملاءمة.
لإدارة دورة حياة المعلومات بفعالية، تصبح البيانات الوصفية (Metadata) عنصراً لا غنى عنه. لنفترض أن 'شركة الأفق للتجارة الإلكترونية' تعتمد على مساعد ذكي للإجابة على استفسارات العملاء حول منتجاتها وسياسات الشحن والعروض الترويجية. هذه المعلومات تتسم بالتغير المستمر. لضمان أن المساعد لا يقدم بيانات قديمة، يجب أن تحمل كل وحدة معلومات – سواء كانت مستنداً كاملاً أو جزءاً محدداً – بيانات وصفية تحدد صلاحيتها. يمكن أن تتضمن هذه البيانات حقولاً مثل `تاريخ_السريان_من` و`تاريخ_السريان_إلى`. هذه الحقول تمكّن المساعد من تصفية المصادر واسترجاع فقط تلك التي تقع ضمن النطاق الزمني الحالي.
يتطلب النهج الاستباقي لإدارة دورة حياة المعلومات تحديد ملكية واضحة وجدولة مراجعات دورية. يجب تعيين `مالك_المعلومة` لكل مستند أو قسم حيوي، وهو الشخص أو الفريق المسؤول عن محتواه. كما يجب تحديد `تاريخ_المراجعة_المقرر`، وهو موعد دوري لمراجعة المحتوى، حتى لو لم يكن له تاريخ انتهاء صلاحية محدد. على سبيل المثال، قد تكون سياسة الإرجاع العامة لـ 'شركة الأفق' سارية المفعول لأجل غير مسمى، ولكن مراجعتها السنوية ضرورية للتأكد من توافقها مع الممارسات التجارية والقوانين. هذا يضمن عدم تقادم المعلومات بسبب الإهمال.
تتضمن دورة التحديث الفعالة خطوات متسلسلة. أولاً، نظام آلي يرسل تنبيهات إلى `مالك_المعلومة` عند اقتراب `تاريخ_السريان_إلى` أو حلول `تاريخ_المراجعة_المقرر`. يدعو هذا التنبيه المالك لمراجعة المحتوى. ثانياً، يقوم المالك بتقييم المحتوى: هل لا يزال دقيقاً؟ هل يحتاج إلى تعديل؟ هل يجب سحبه؟ إذا تطلب تحديثاً، تُنشأ نسخة جديدة بـ `تاريخ_سريان_من` جديد و`تاريخ_مراجعة_مقرر` محدث. النسخة القديمة لا تُحذف، بل تُحدَّد حالتها كـ `منتهية_الصلاحية` أو تُنقل إلى مجلد 'أرشيف'. هذا يحافظ على سجل تاريخي للمعلومات، مفيد للتدقيق أو تحليل التغييرات.
عندما يتلقى المساعد الذكي سؤالاً، يستخدم هذه البيانات الوصفية لتصفية المصادر المحتملة. فإذا سأل عميل في 'شركة الأفق' عن 'أحدث العروض الترويجية'، سيبحث المساعد عن المستندات أو الأقسام التي تحمل علامة `نوع_المستند: عرض_ترويجي`. ثم يقوم بتصفية النتائج بناءً على `تاريخ_السريان_من` و`تاريخ_السريان_إلى` للتأكد من سريان العروض حالياً. المصادر التي يكون `تاريخ_السريان_إلى` الخاص بها في الماضي تُتجاهل تلقائياً في الاستجابات العادية. هذه الآلية تمنع المساعد من تقديم عروض انتهت صلاحيتها، مما يحمي سمعة الشركة ويمنع سوء الفهم.
يعتمد قرار مستوى تفاصيل انتهاء الصلاحية (مستند كامل أم فقرات محددة) على طبيعة المعلومات. فالعروض الترويجية قصيرة الأجل قد تتطلب تحديد تاريخ انتهاء صلاحية لكل فقرة. أما سياسات الشركة العامة، فقد يكفي تحديد تاريخ للمستند بأكمله. بدائل الأرشفة تشمل استخدام بيانات وصفية إضافية مثل `حالة: تاريخي` أو `حالة: ملغى`، مع ضمان ألا يسترجع المساعد هذه المستندات إلا بطلب صريح لمعلومات تاريخية (مثل: 'ماذا كانت سياسة الإرجاع في عام 2022؟'). هذا يوفر مرونة أكبر مع الحفاظ على سلامة قاعدة المعرفة النشطة.
لنتخيل أن 'شركة الأفق' أطلقت عرضاً ترويجياً جديداً: 'خصم 20% على جميع الإلكترونيات' لمدة أسبوعين، وقام فريق التسويق بتحميل تفاصيله مع تحديد `تاريخ_السريان_إلى` بدقة. لكن، بسبب سهو في عملية التحديث، لم تُحدّث حالة العرض الترويجي السابق 'خصم 10% على منتجات مختارة' إلى `منتهية_الصلاحية`، أو عُيّن `تاريخ_السريان_إلى` الخاص به بالخطأ في المستقبل البعيد. عندما يسأل عميل المساعد الذكي عن 'أحدث الخصومات'، يسترجع المساعد كلا العرضين لأنهما يبدوان ساريين. قد يدمج المساعد المعلومات بشكل خاطئ، أو يعطي الأولوية للعرض الأقل فائدة، أو يقدم إجابات متناقضة، مما يؤدي إلى ارتباك العميل واستيائه.
تتطلب معالجة مثل هذا الفشل نهجاً متعدد الأوجه. أولاً، يجب وجود نظام لمراقبة استجابات المساعد الذكي، خاصة تلك المتعلقة بالمعلومات الحساسة زمنياً، عبر مراجعة عشوائية أو تحليل ملاحظات العملاء. ثانياً، يُجرى تدقيق دوري للمستندات ذات تواريخ انتهاء الصلاحية، لتحديد المستندات التي كان يجب أن تنتهي صلاحيتها لكنها لا تزال نشطة. يمكن لتقرير أسبوعي يسرد المستندات التي تنتهي صلاحيتها قريباً أو انتهت بالفعل أن يكون فعالاً. ثالثاً، عند اكتشاف التناقض، تُصحح البيانات الوصفية للعرض القديم فوراً، بتحديد حالته كـ `منتهية_الصلاحية`. أخيراً، والأهم هو مراجعة عملية التحديث نفسها: هل كان الخطأ في إدخال البيانات الوصفية أم في نظام المعالجة؟ يجب إضافة خطوة تحقق يقوم فيها شخص بتأكيد حالة العروض القديمة بعد إطلاق عرض جديد، لضمان عدم تكرار المشكلة. هذا النهج التكراري للتحسين المستمر أساسي للحفاظ على قاعدة معرفة موثوقة.
أُعد هذا الدليل بمساعدة الذكاء الاصطناعي، مع تحرير ومراجعات آلية للمحتوى والمعنى. الأمثلة التعليمية افتراضية، ولا تمثل تجربة عميل أو نتائج تشغيل مقاسة.

التعليقات
كن أول من يعلّق على هذا المقال.